DAY 09작업 9일째
글이 늘어나도 찾을 수 있게 글 목록을 바꿨다
작업한 날 순서와 다 펼친 태그, 한 페이지에 다 그린 카드로는 글이 쌓일수록 찾기도 보기도 어려워서, 올린 순서로 정렬하고 글 찾기 패널과 무한 스크롤을 서버 없이 만들었다.
프로젝트 하나를 한꺼번에 발행하고 글 목록을 열었더니, 방금 올린 글이 맨 아래에 있었다. 목록이 글마다 적힌 「작업한 날」 순서라, 9월에 한 작업을 10월에 정리해 올리면 오래된 글 사이에 묻혔다. 태그 필터를 목록 위에 붙이고 나니 다음 문제도 보였다. 태그를 전부 펼쳐 두면 글이 늘수록 태그가 화면을 덮고, 2000편쯤 되면 원하는 글이나 첫 글을 찾으러 가는 것 자체가 일이 된다.
목록은 블로그에 올린 순서로
글마다 「올린 시각」을 따로 적어 두지 않고 git 기록에서 찾기로 했다. 발행은 머리말의 draft: true 를 false 로 바꾸는 커밋이라, 글 파일의 기록을 거꾸로 훑어 초안이 마지막으로 풀린 커밋 시각을 쓴다. 처음부터 공개로 만든 글은 만든 커밋 시각이 된다. 내렸다가 다시 올린 글은 다시 올린 시각으로 간다.
const added = commit.match(/^\+draft:\s*(\S+)/m)?.[1];
const next = added ? added === 'true' : /^-draft:/m.test(commit) ? false : (draft ?? false);
if (!next && draft !== false) at = commit.slice(0, commit.indexOf('\n'));
카드에 보이는 날짜와 프로젝트 안의 기록 번호(#01, #02…)는 그대로 작업한 순서를 따른다. 목록만 올린 순서로 바뀐다.
검색과 조건을 한 패널에
글을 찾는 방법을 목록 위에 흩어 두지 않고 「글 찾기」 패널 하나로 모았다. 넓은 화면에서는 왼쪽에 붙어 스크롤해도 따라온다.
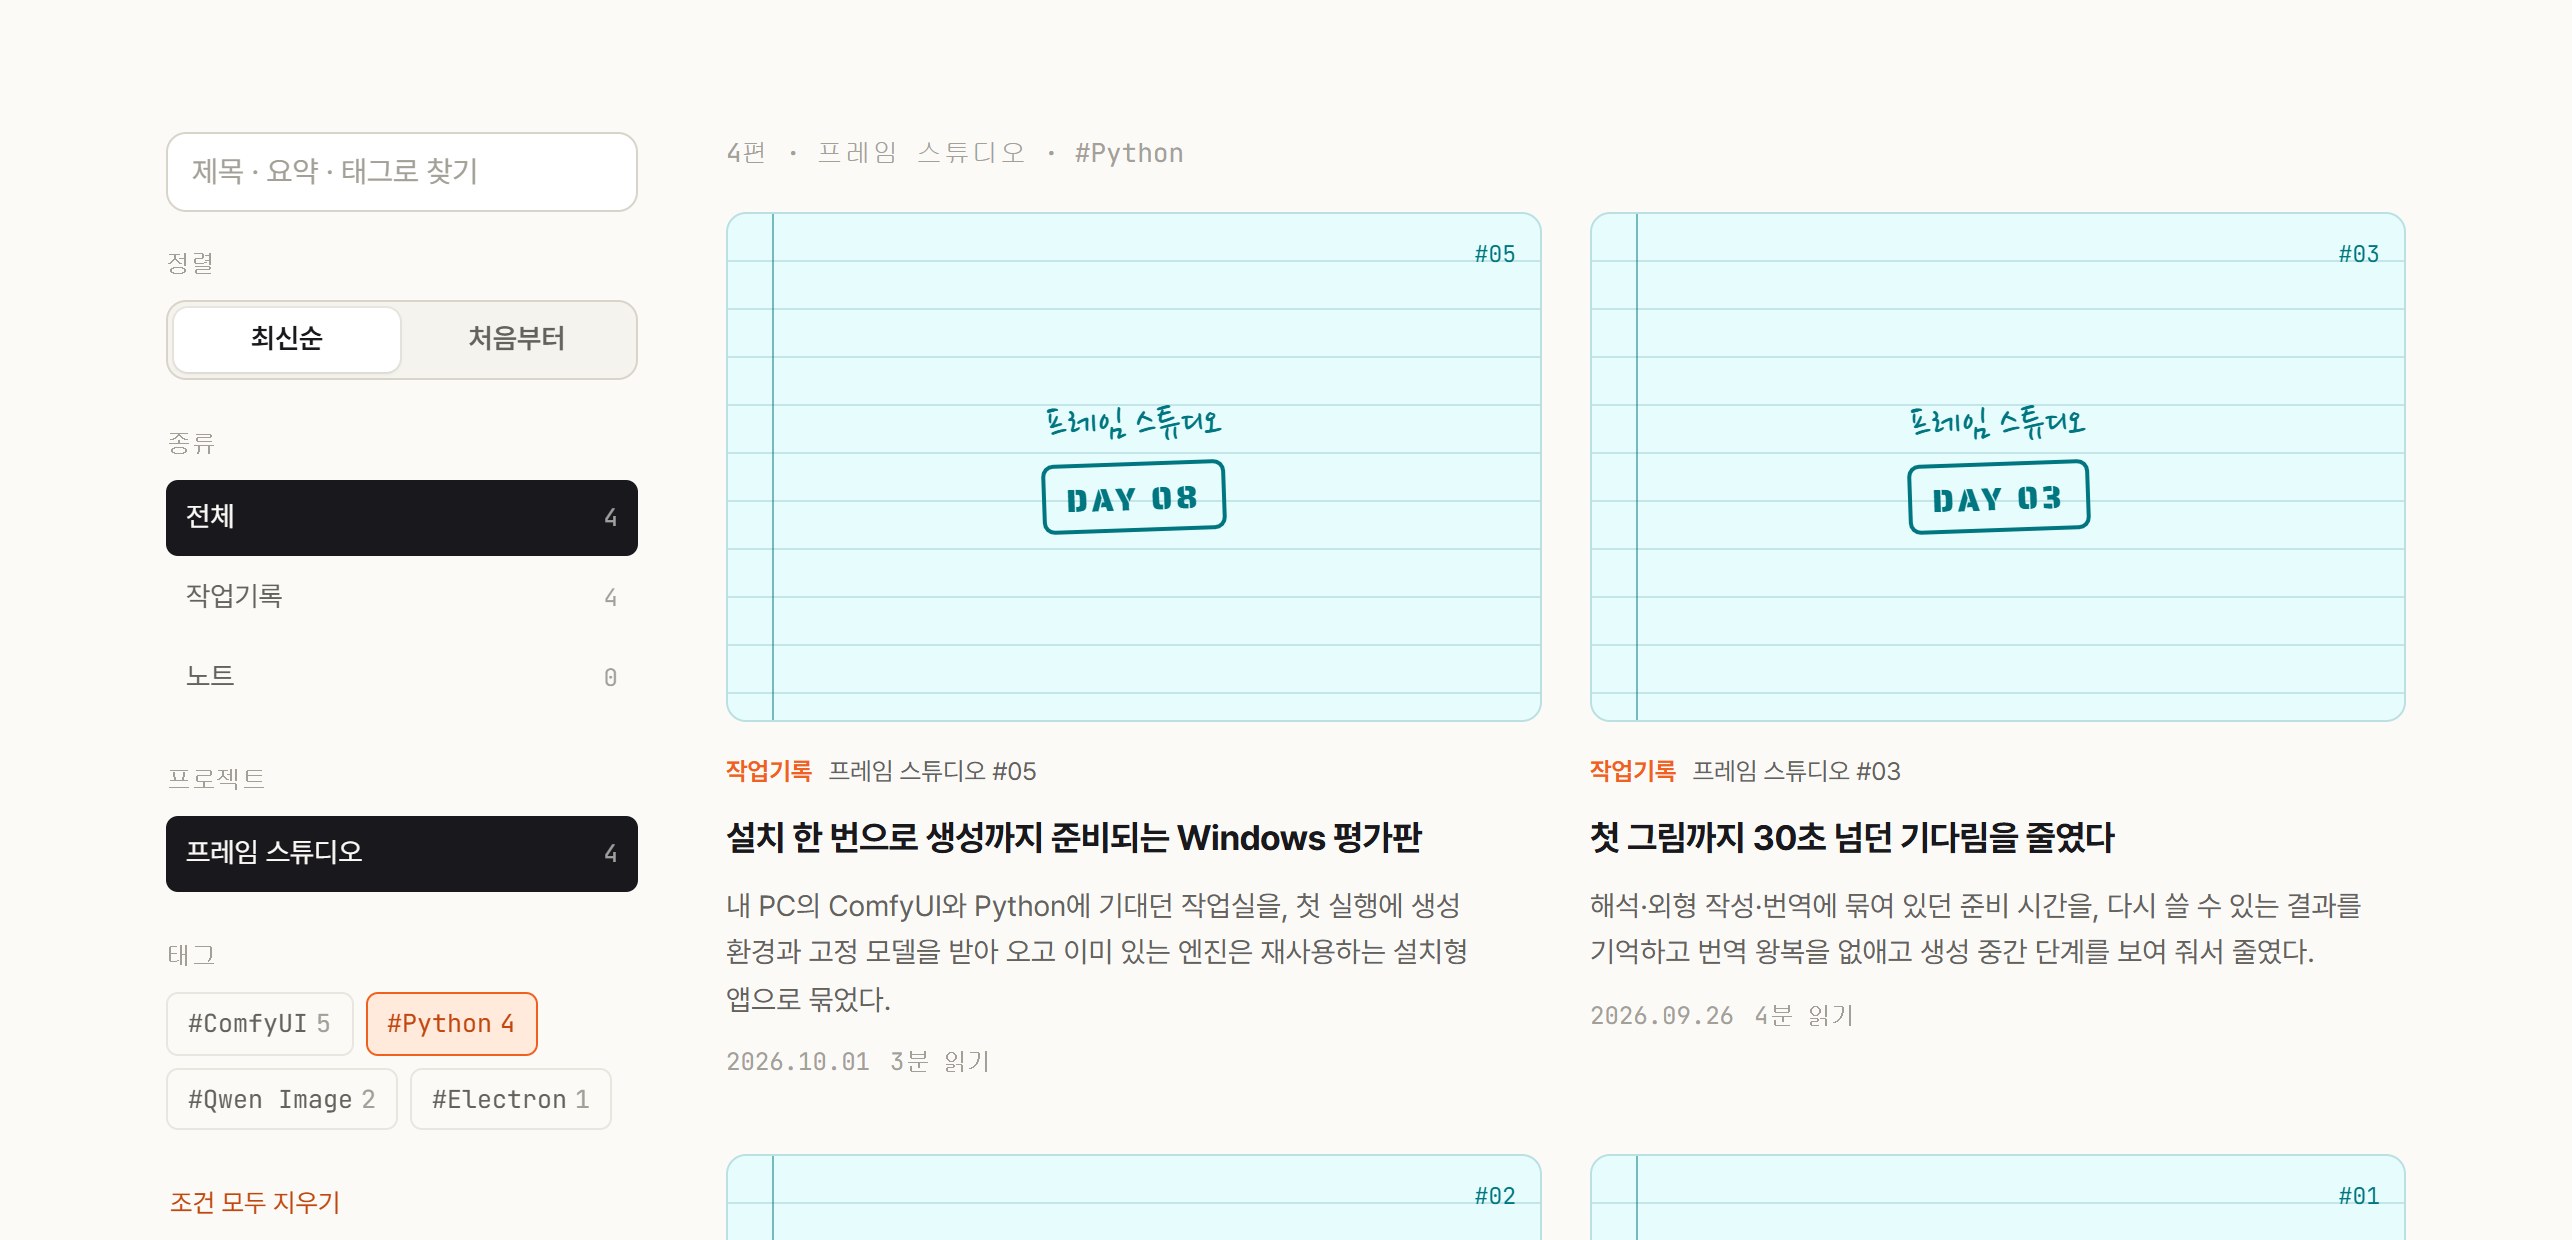
- 검색: 제목과 본문, 태그로 찾는다.
- 정렬: 최신순과 「처음부터」. 첫 글은 처음부터 한 번이면 맨 위에 온다.
- 종류, 프로젝트, 태그: 하나씩 고르고, 고른 것을 다시 누르면 푼다.
칸마다 붙은 숫자는 「그 칸을 뺀 나머지 조건」 안에서 센다. 태그를 하나 골라 두면 프로젝트 칸에는 그 태그를 쓴 프로젝트와 편수만 남아서, 누르기 전에 몇 편이 남을지 보인다. 고른 조건은 주소(?q, type, project, tag, sort)에도 남아 그대로 링크로 보낼 수 있다. 조건을 지우는 버튼은 결과 위 「4편 · 프레임 스튜디오」 같은 줄 끝에 두었다. 무엇으로 걸렀는지 보이는 자리에서 바로 풀 수 있게 하려는 것이다.
태그와 프로젝트는 처음에 앞쪽 몇 개만 보이고 나머지는 「+N개 더」로 접힌다. 처음에는 원래 순위로 접었는데, 태그를 고르자 남은 프로젝트가 모두 접힌 쪽에 있어서 「+1개 더」만 덩그러니 보였다. 그래서 접는 기준을 「지금 남은 것 중 앞쪽」으로 바꿨다.
휴대폰에서는 아래에서 올라오는 시트로
처음에는 좁은 화면에서 필터가 검색창 아래로 펼쳐지게 했다. 그런데 조건을 고르고 나면 결과를 보러 한참 내려가야 했다. 그래서 검색줄은 위에 붙여 두고, 「필터」를 누르면 화면 아래에서 시트가 올라오게 바꿨다. 고르는 대로 바로 걸러지고, 시트 맨 아래 버튼에 「5편 보기」처럼 남은 편수가 보여서 누르면 닫히며 결과가 나온다. 고른 조건은 검색창 아래에 칩으로 남아, 시트를 다시 열지 않고 하나씩 풀 수 있다.
서버 없이 2000편을 버티게
처음에는 모든 카드를 한 페이지에 그려 두고 그 안에서 걸렀다. 이 블로그는 빌드할 때 만든 파일을 그대로 나눠 주는 정적 사이트라, 요청마다 필요한 24편만 골라 주는 서버가 없다. 그렇다고 글 수천 편의 카드를 한 페이지에 실으면 페이지가 너무 무거워진다.
처음에는 글마다 거르기 재료를 한 줄씩 담은 검색용 목록을 직접 만들었다. 실제 파일로 재 보니 글 한 편에 380바이트쯤이라, 2000편이면 압축해도 200KB가 넘었다. 그래서 정적 사이트용 검색 도구인 Pagefind로 바꿨다. 빌드가 끝나면 Pagefind가 글 페이지를 읽어 색인을 낱말별 작은 조각으로 쪼개 두고, 브라우저는 검색이나 거르기에 필요한 조각만 받아 온다. 덤으로 본문 전체가 검색된다.
글 페이지에는 Pagefind가 읽을 재료를 숨은 칸으로 실었다. 종류, 프로젝트, 태그는 거르기 값이 되고, 올린 시각은 정렬 값이 되고, 카드 HTML은 통째로 따라붙는다. 글 목록은 검색 결과를 받아 그 카드를 그대로 이어 붙인다.
<div hidden data-pagefind-ignore data-card="…카드 HTML…" data-pagefind-meta="card[data-card], year[data-year]"
     data-pagefind-sort="published[data-published]" data-pagefind-filter="type[data-type]">
  <span data-pagefind-filter="project">frame-studio</span><span data-pagefind-filter="tag">Python</span>
</div>
첫 쪽 24편은 HTML로 그려 두고, 그냥 목록을 내려 보는 동안은 아무것도 받지 않는다. 끝에 가까워지거나 조건을 고르는 순간 처음으로 Pagefind를 불러 다음 24편을 붙인다. 스크립트가 돌지 않으면 /posts/page/2/ 같은 쪽 번호 페이지로 지난 글에 닿고, 검색 로봇도 이 길로 모든 글을 찾는다. 이 블로그는 저장소에 외부 패키지를 두지 않는 원칙이라, Pagefind는 버전을 고정해 빌드 때 npx 로 부른다. 색인을 못 만들면 검색만 빠지고 빌드는 계속된다.
조건을 빠르게 바꾸면 먼저 찾으러 간 결과가 늦게 도착해 새 결과 위에 섞일 수 있어서, 조건이 바뀔 때마다 번호를 올리고 번호가 다른 결과는 버린다. 같은 이유로 첫 화면의 포스트잇은 최근 60편 안에서 고르고, 구독 피드는 최근 30편만 싣게 했다. 둘 다 전체 글을 담고 있어서 글이 많아지면 같이 무거워질 곳이었다.
감수한 것
한국어는 Pagefind가 어간을 분석하지 못한다. 낱말 앞부분으로는 찾아지지만(「샘플」로 「샘플러」), 활용형끼리 묶어 주지는 않는다. KSamplerAdvanced 처럼 대소문자가 섞인 코드 이름은 「sampler」, 「advanced」로 쪼개 색인해서 통째로 치면 엉뚱한 글이 나오고, 쪼갠 낱말로 쳐야 정확하다. 빌드할 때 git 기록과 npx 가 필요해서, 기록 없이 받은 사본에서는 올린 순서 대신 작업한 날로 정렬되고 인터넷이 안 되면 검색 색인이 빠진다.
AI(Claude Code)가 작업 기록을 바탕으로 쓰고, 검토를 거쳐 올린 글이에요. 어떻게 쓰이나요 →